Connettori Dati
Riferimento completo per tutti i connettori disponibili. Ogni connettore permette di importare dati da una sorgente specifica per la stampa etichette.
Tutti i connettori seguono lo stesso workflow: selezione del tipo sorgente, configurazione della connessione, selezione dei dati e mappatura dei campi. Per il workflow generale, consulta la guida Tabelle / Database.
File
Excel / ODS
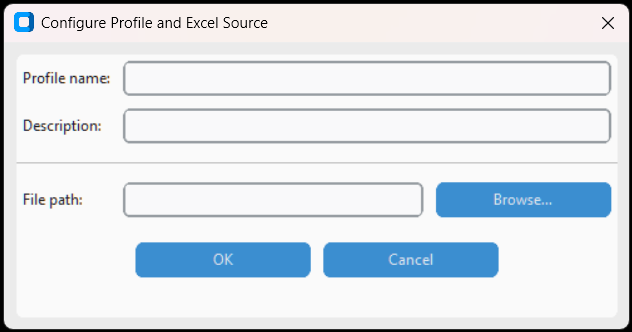
Importa dati da file Microsoft Excel (.xlsx, .xlsm, .xls, .xlsb) e LibreOffice Calc (.ods). Seleziona il foglio desiderato dopo la connessione.
- Profile name / Description — Nome e descrizione del profilo dati
- File path — Percorso al file Excel/ODS. Usa Sfoglia per selezionare
Dopo OK, viene mostrata la lista dei fogli disponibili. Seleziona il foglio da usare come sorgente dati.
CSV / Testo
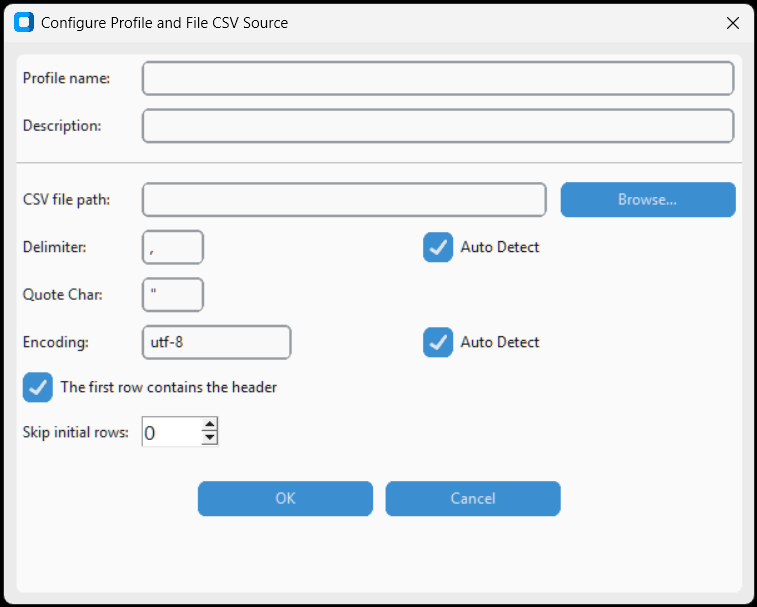
Importa dati da file CSV e testo delimitato. Configura delimitatore, carattere di citazione, encoding e intestazione. Il pulsante Rileva Auto rileva automaticamente le impostazioni.
- CSV file path — Percorso al file CSV/testo
- Delimiter — Carattere separatore (virgola, punto e virgola, tab, ecc.)
- Quote Char — Carattere di citazione per campi con delimitatori interni
- Encoding — Codifica del file (utf-8, latin-1, ecc.)
- La prima riga contiene l'intestazione (header) — Indica se la prima riga contiene i nomi dei campi
- Rileva Auto — Rileva automaticamente delimitatore, citazione ed encoding
Microsoft Access

Connessione diretta a database Microsoft Access (.mdb, .accdb). Supporta password database, selezione driver e query personalizzate.
- Access database path — Percorso al file .mdb o .accdb
- Database Password — Password del database (se protetto)
- Access driver — Driver Access installato. Altri... mostra i driver disponibili
- RECOMMENDED: Use Read Uncommitted — Evita blocchi database durante la lettura
- Query Personalizzata — Query SQL personalizzata (opzionale). Apri Editor Query apre l'editor visuale
Apache Parquet
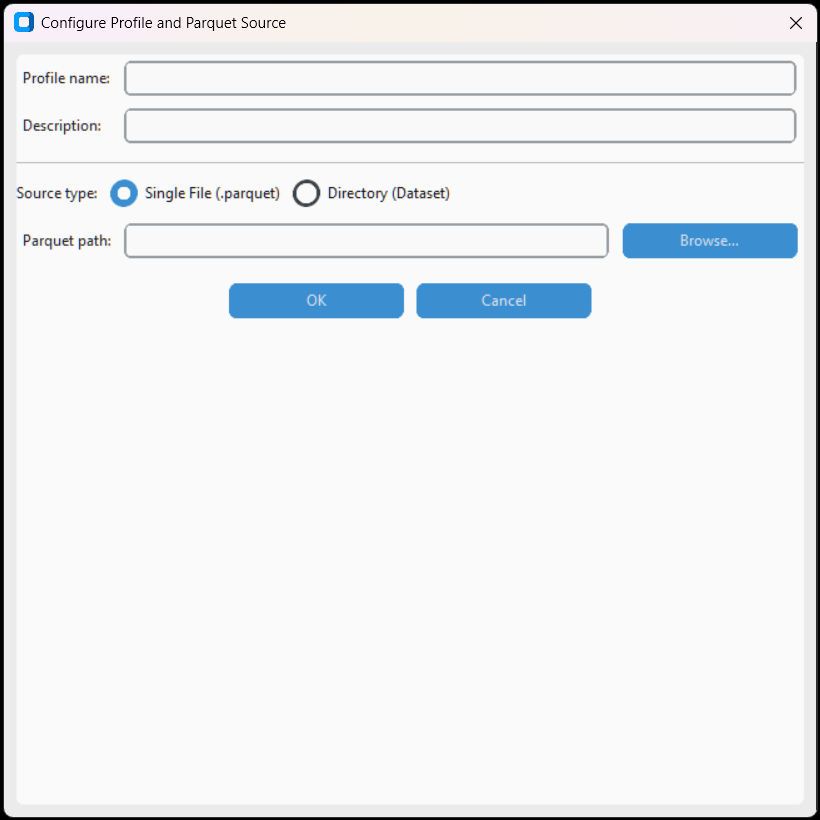
Legge file Apache Parquet, formato colonnare ad alte prestazioni. Ideale per dataset di grandi dimensioni.
- File path — Percorso al file .parquet
- Read uncommitted — Ottimizzazione performance lettura
Feather / Arrow IPC
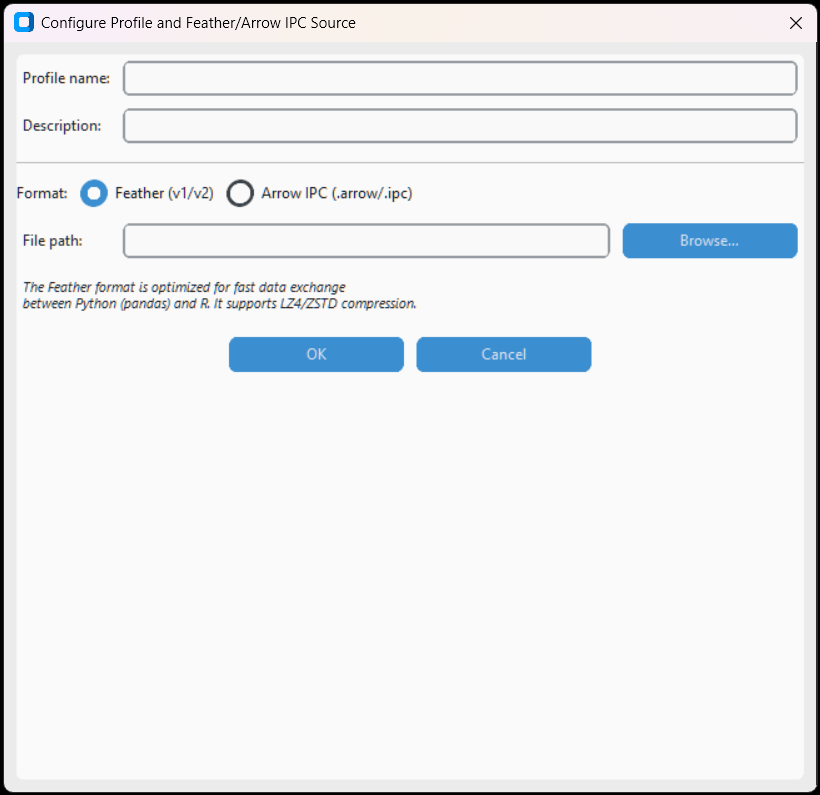
Legge file Feather e Arrow IPC, formato binario veloce per lo scambio dati tra applicazioni.
SPSS / SAS / Stata

Legge file statistici: SPSS (.sav), SAS (.sas7bdat) e Stata (.dta). Utilizza la libreria pyreadstat.
Apache Avro
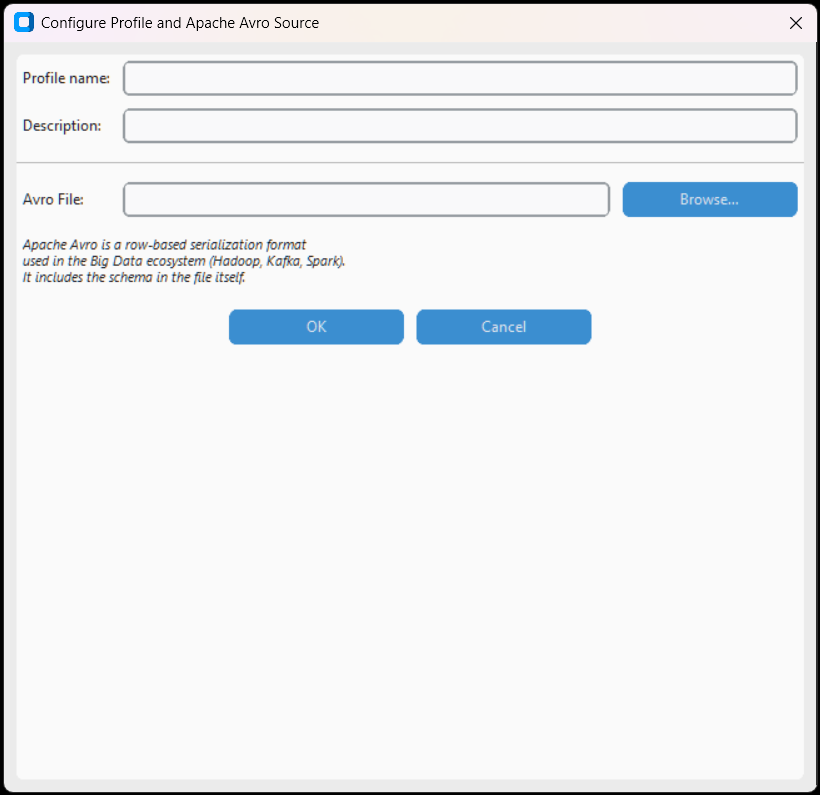
Legge file Apache Avro, formato binario con schema integrato, usato in ecosistemi Hadoop e streaming.
HDF5

Legge file Hierarchical Data Format 5, usato per dati scientifici e ingegneristici di grandi dimensioni.
GeoPackage / GeoJSON / Shapefile
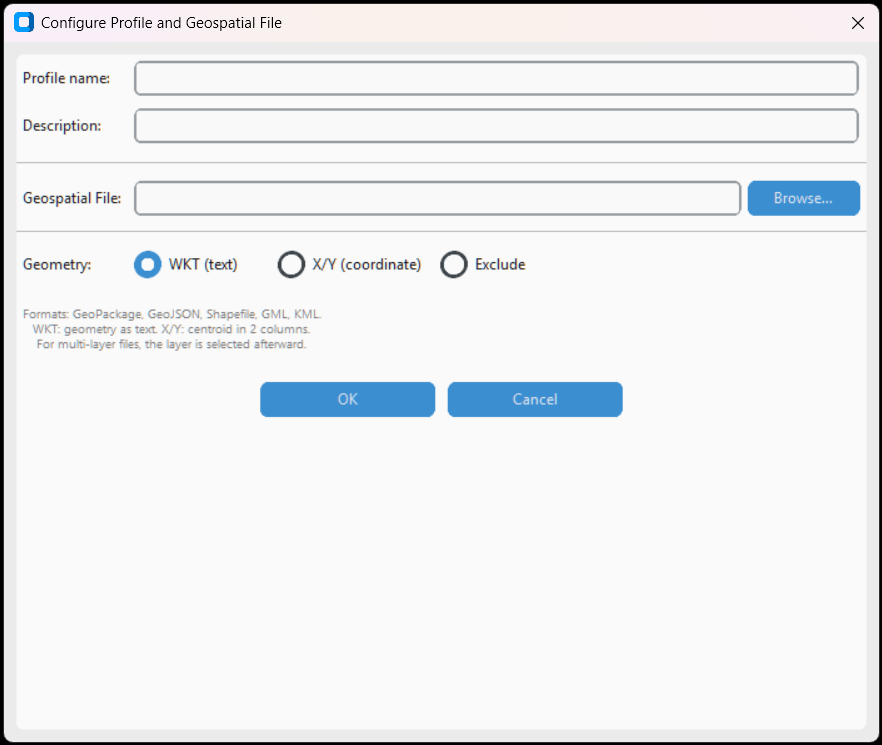
Importa dati geospaziali da GeoPackage, GeoJSON e Shapefile. Supporta WKT, GeoJSON e formati coordinati.
- WKT (testo) — Geometria in formato testuale
- XY Coordinates — Colonne separate per latitudine/longitudine
- Encoded — Geometria codificata (GeoJSON, WKB)
File Connessione Dati Office (.odc)
Legge file ODC (Office Data Connection) creati da Excel o altri prodotti Office per riutilizzare connessioni predefinite.
JSON / XML
Importa dati strutturati da file JSON e XML locali. Supporta array nidificati e percorsi XPath.
Database relazionali
Microsoft SQL Server
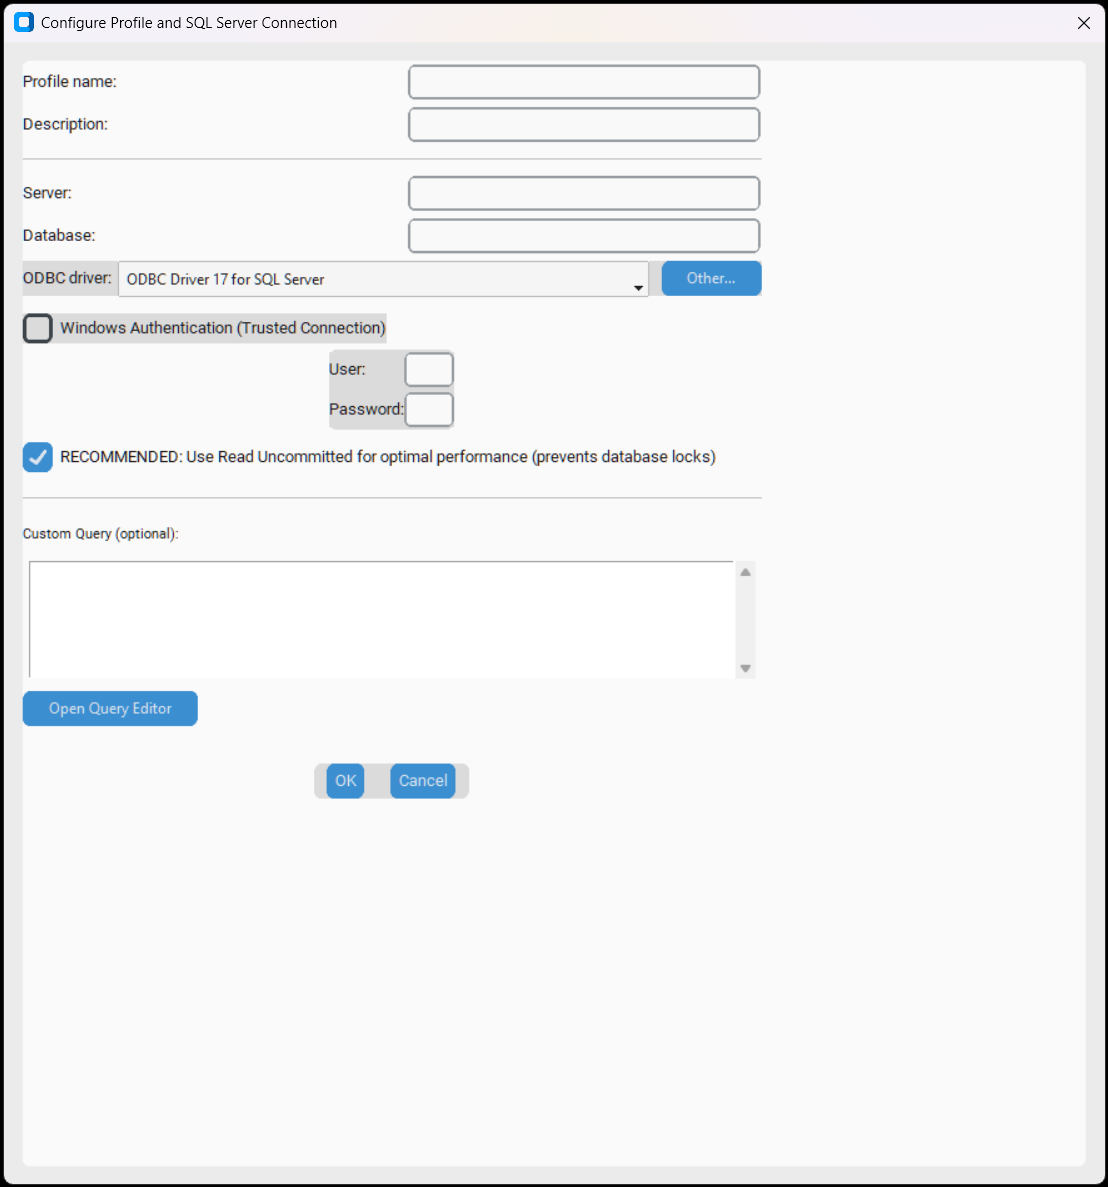
Connessione a Microsoft SQL Server. Supporta autenticazione Windows (Trusted Connection) e SQL Server, selezione driver ODBC, e query personalizzate.
- Server — Nome o IP del server (es.
localhost,server\instance) - Database — Nome del database
- Driver ODBC — Driver installato (es. ODBC Driver 17 for SQL Server). Altri... mostra i driver disponibili
- Windows Authentication — Usa le credenziali Windows correnti (Trusted Connection)
- User / Password — Credenziali SQL Server (se non si usa Windows Auth)
- RECOMMENDED: Use Read Uncommitted — Previene blocchi database
- Query Personalizzata — Query SQL personalizzata con editor integrato
MySQL
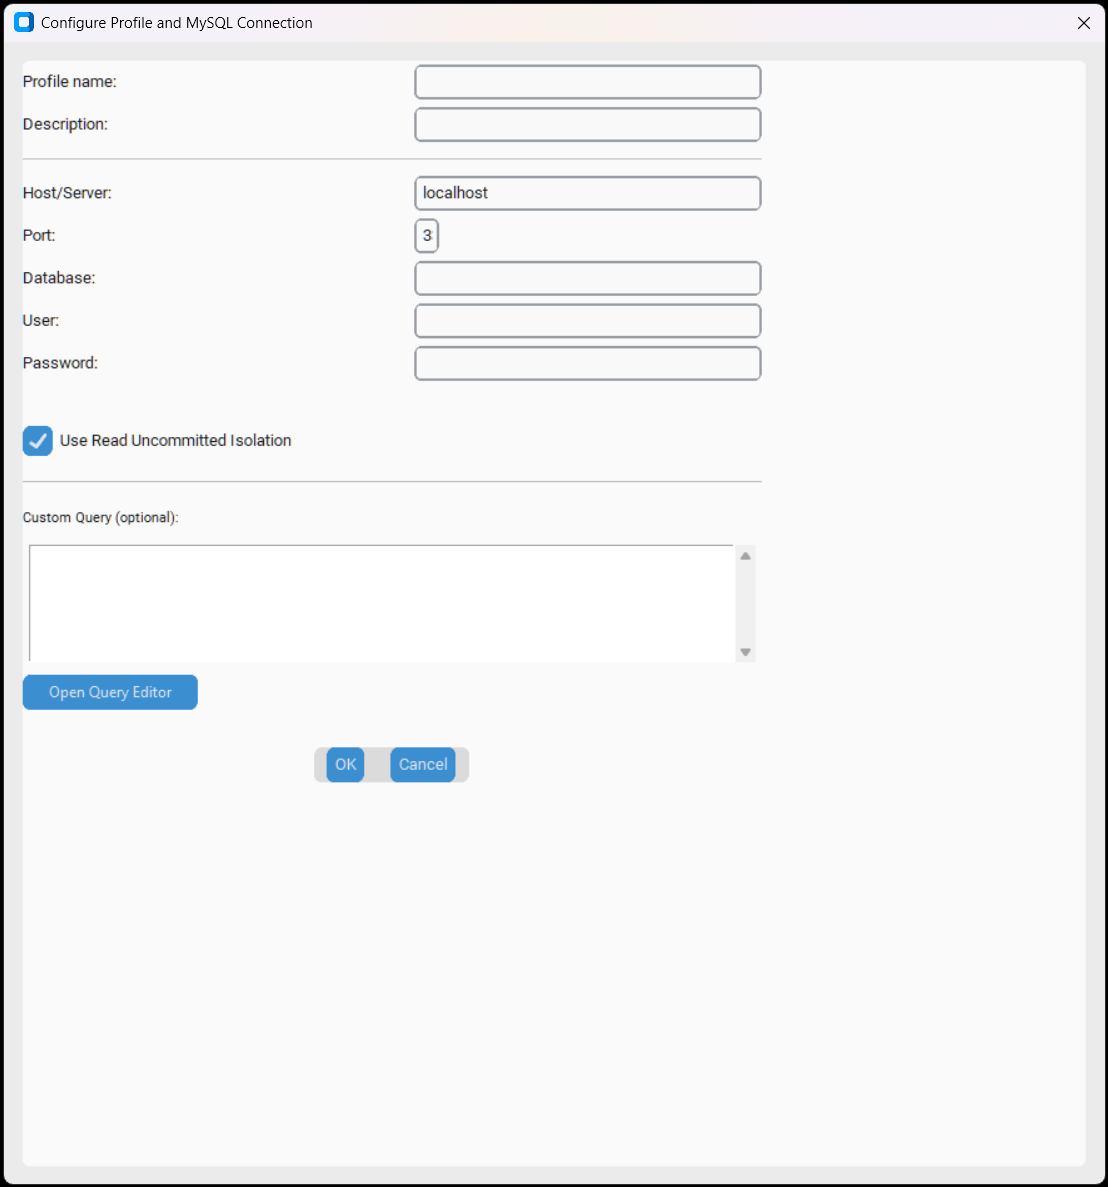
Connessione a MySQL e MariaDB. Configura host, porta, database, credenziali e query personalizzate.
- Host/Server — Indirizzo del server (default:
localhost) - Porta — Porta (default:
3306) - Database — Nome del database
- User / Password — Credenziali di accesso
- Usa Isolamento Read Uncommitted — Evita blocchi in lettura
- Query Personalizzata — Query SQL personalizzata con editor integrato
PostgreSQL
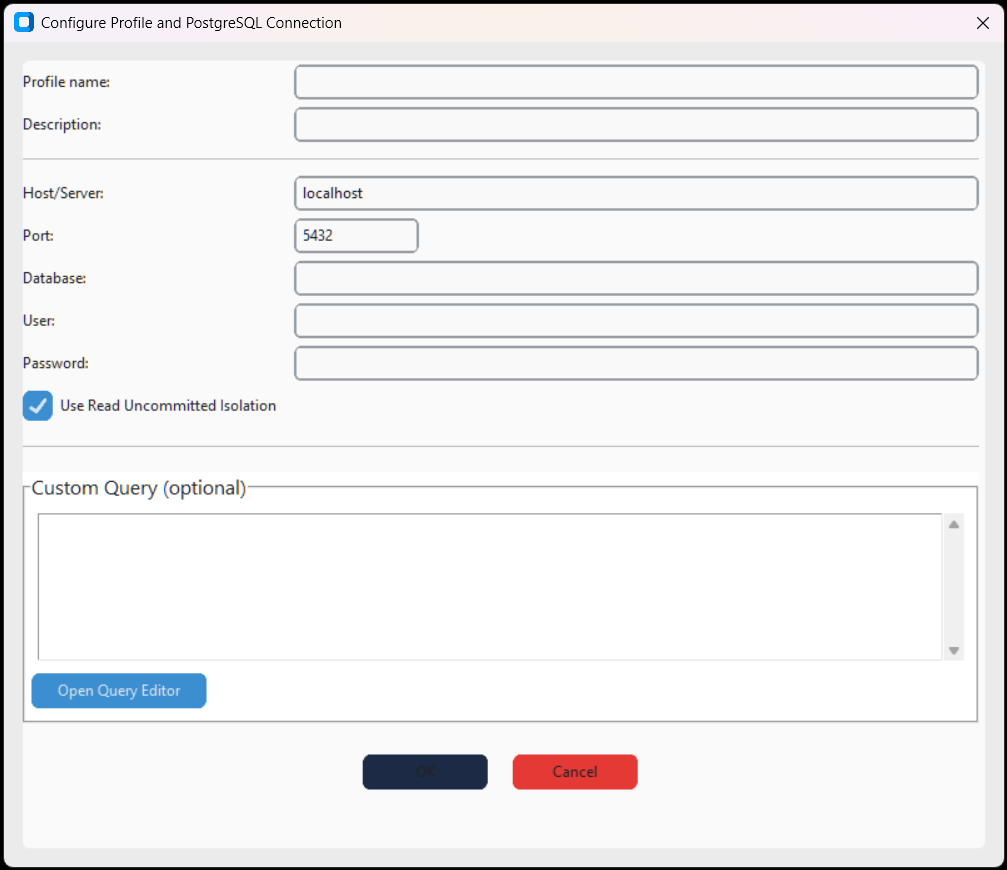
Connessione a PostgreSQL. Supporta connessione standard e SSL, con query personalizzate.
- Host / Port — Server e porta (default:
5432) - Database — Nome del database
- User / Password — Credenziali
- Use SSL — Abilita connessione cifrata
- Query Personalizzata — Query SQL personalizzata
Oracle Database
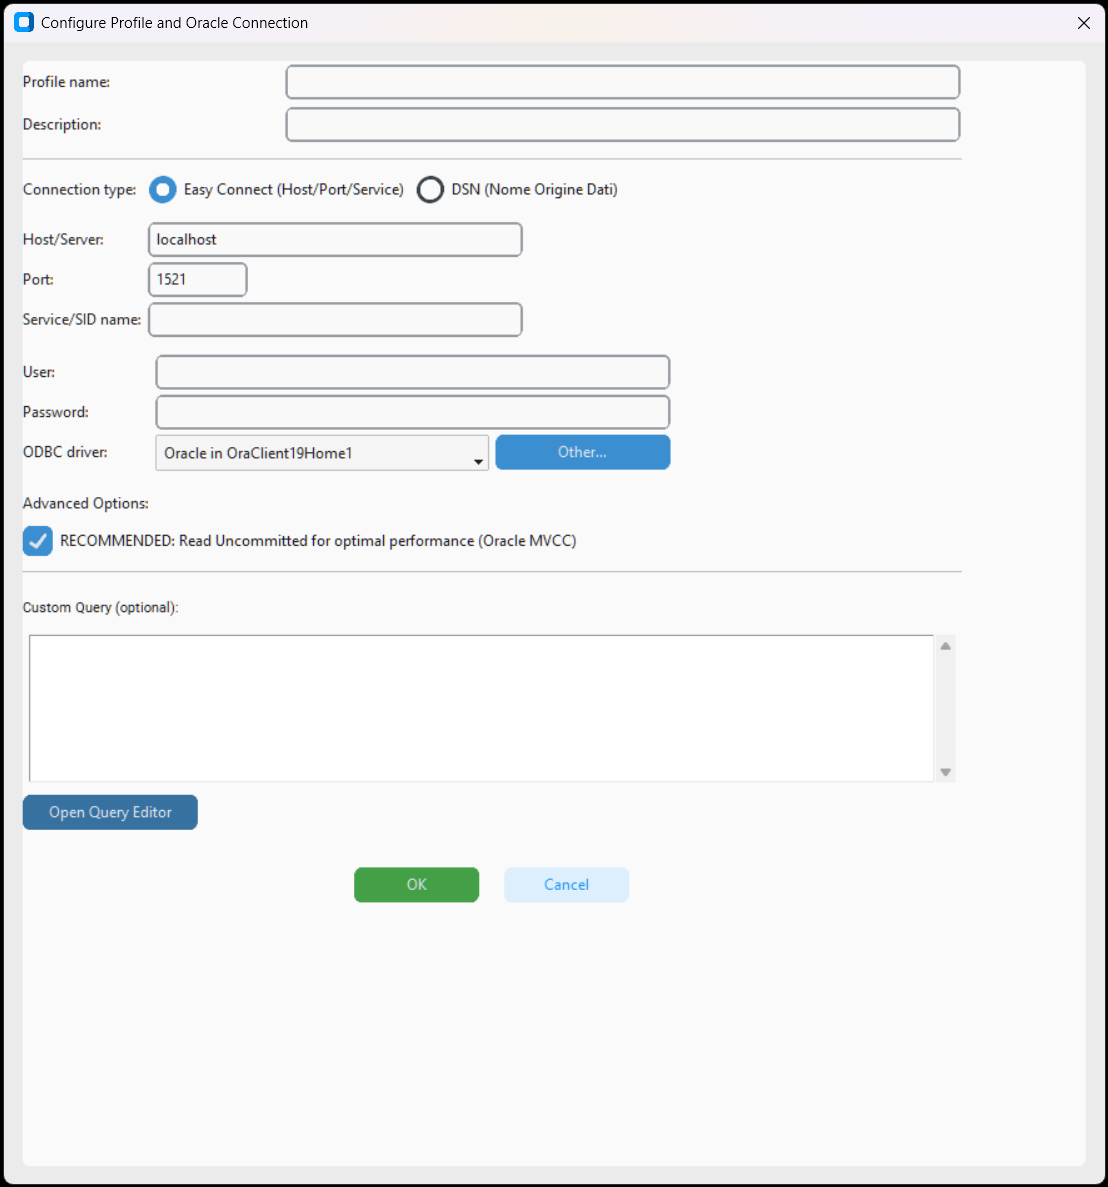
Connessione a Oracle Database. Supporta Easy Connect e Oracle Instant Client, con selezione driver e query personalizzate.
- Tipo Connessione — Easy Connect (Host/Port/Service) o DSN
- Host/Server, Port, Service/SID name — Parametri di connessione Easy Connect
- Driver ODBC — Oracle Instant Client driver
- RECOMMENDED: Read Uncommitted — Usa Oracle MVCC per performance
- Query Personalizzata — Query SQL personalizzata con editor
IBM Db2
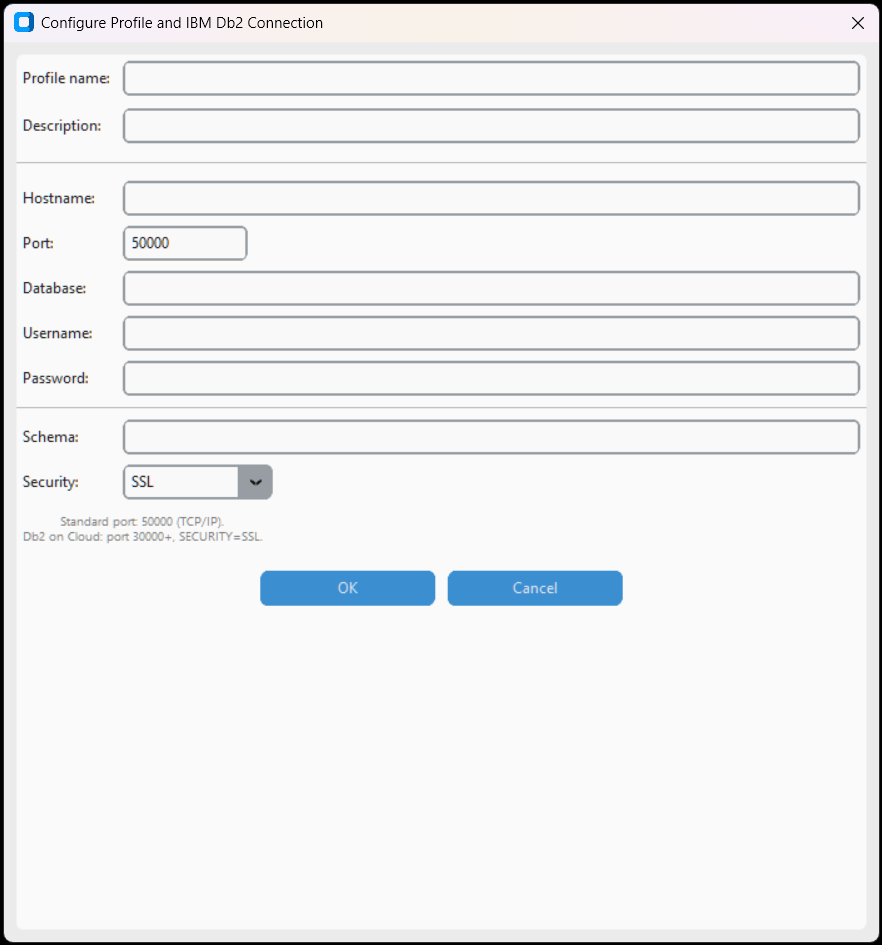
Connessione a IBM Db2. Configura host, porta, database e credenziali. Supporta SSL/TLS.
- Host / Port — Server e porta (default:
50000) - Database — Nome del database
- Username / Password — Credenziali
- Usa SSL/TLS — Connessione cifrata
ClickHouse
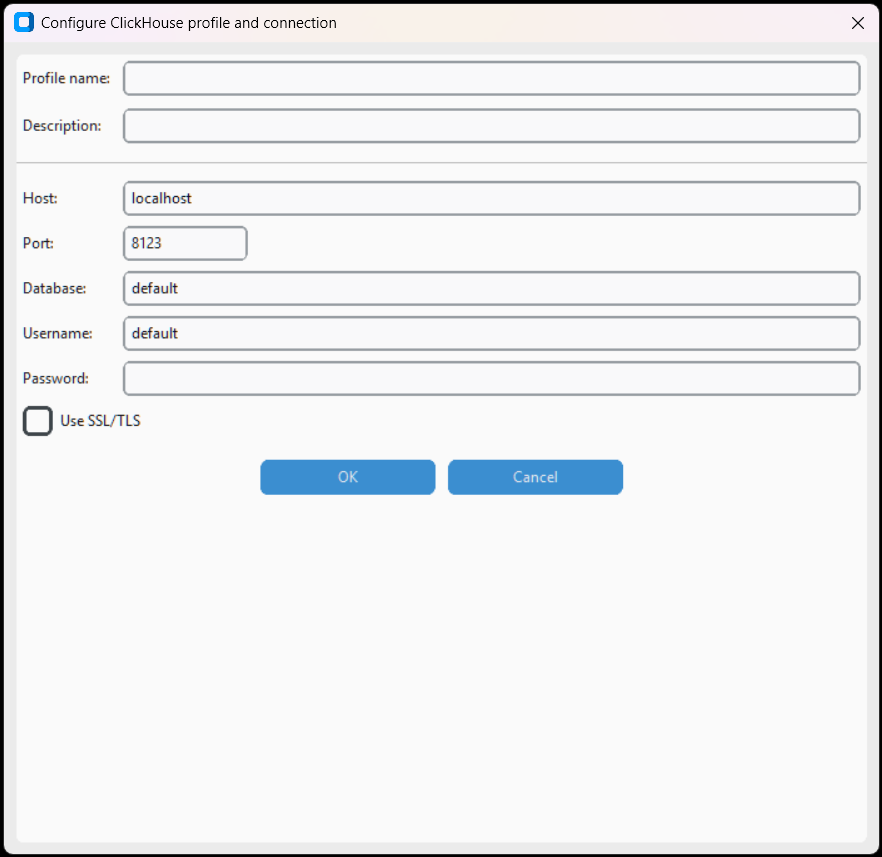
Connessione a ClickHouse, database OLAP colonnare. Configura host, porta HTTP, database e credenziali.
- Host / HTTP Port — Server e porta HTTP (default:
8123) - Database — Nome del database
- Username / Password — Credenziali (default user:
default) - Use SSL — HTTPS
Trino (SQL Gateway)
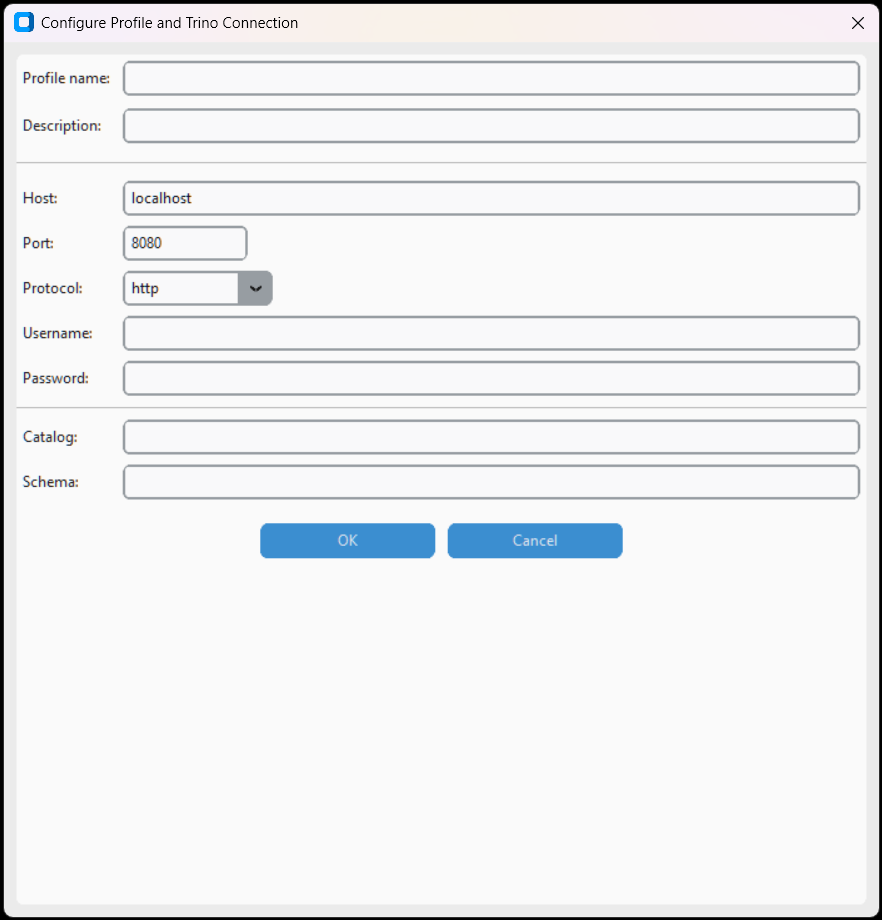
Connessione a Trino (ex Presto). Gateway SQL distribuito per query federate su sorgenti dati diverse.
- Host / Port — Coordinatore Trino (default:
8080) - Catalog / Schema — Catalogo e schema dati
- Username / Password — Credenziali
- Use SSL — HTTPS
Big Data e Analytics
Snowflake Data Cloud
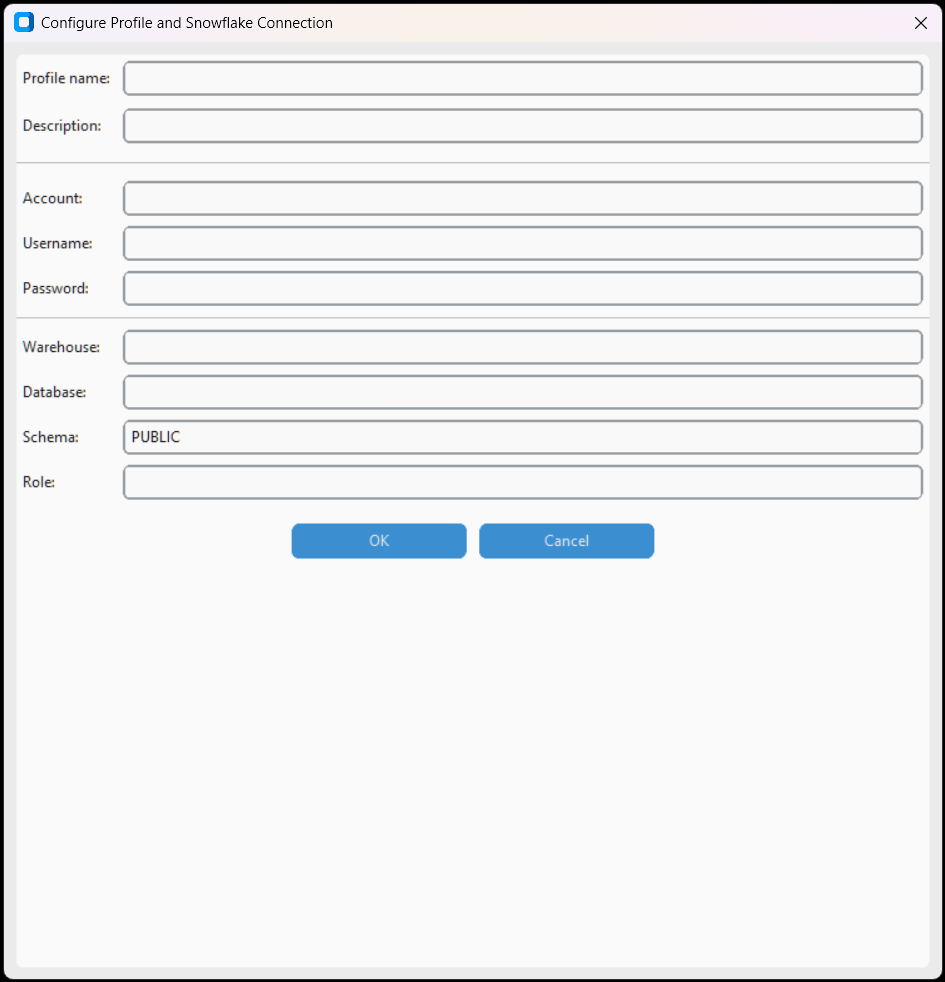
Connessione a Snowflake. Configura account, warehouse, database, schema e credenziali.
- Account — Identificativo account Snowflake (es.
xy12345.eu-west-1) - Magazzino — Warehouse di elaborazione
- Database / Schema — Database e schema target
- Username / Password — Credenziali
- Role — Ruolo Snowflake (opzionale)
Databricks SQL
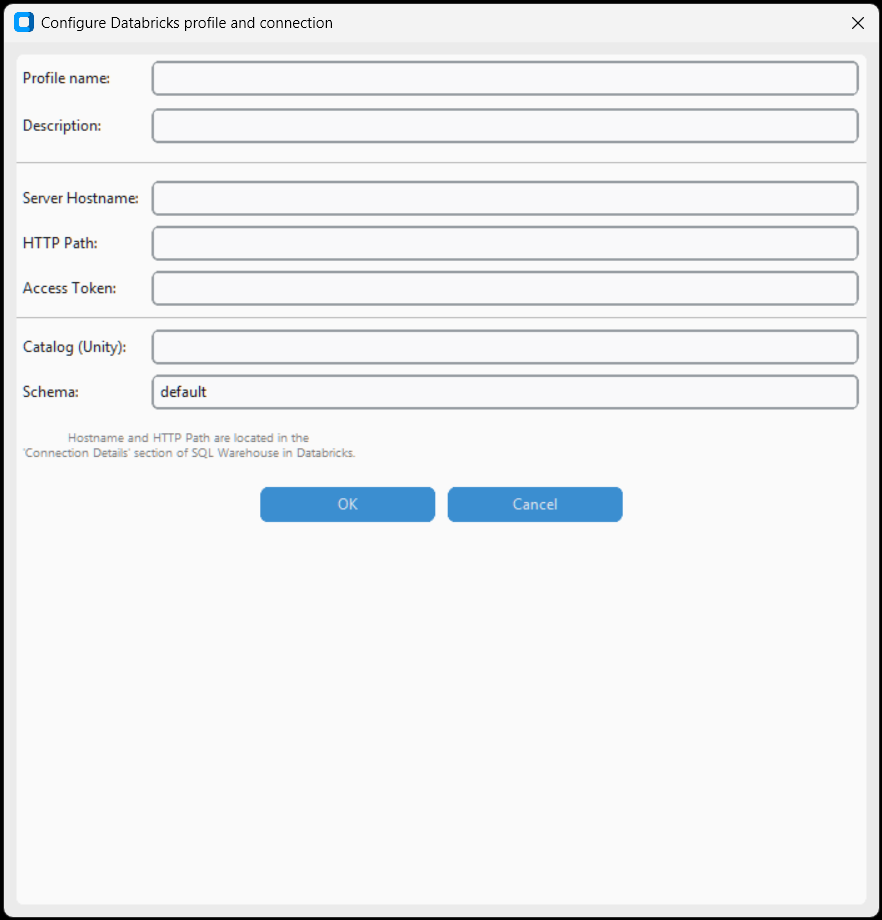
Connessione a Databricks SQL Analytics. Configura host, percorso HTTP, token di accesso e catalogo.
- Server hostname — Host del workspace Databricks
- HTTP path — Percorso SQL warehouse
- Access token — Token di autenticazione personale
- Catalog — Catalogo Unity (opzionale)
Google BigQuery

Connessione a Google BigQuery. Richiede file JSON delle credenziali service account e Project ID.
- Credentials JSON file — File JSON delle credenziali service account Google
- Project ID — ID progetto Google Cloud
DuckDB (Analitico Embedded)

Database analitico embedded. Apre file DuckDB locali o crea database in memoria per analisi veloci.
- Database file path — Percorso al file .duckdb (o lascia vuoto per in-memory)
- Read only — Apri in sola lettura
Apache Cassandra
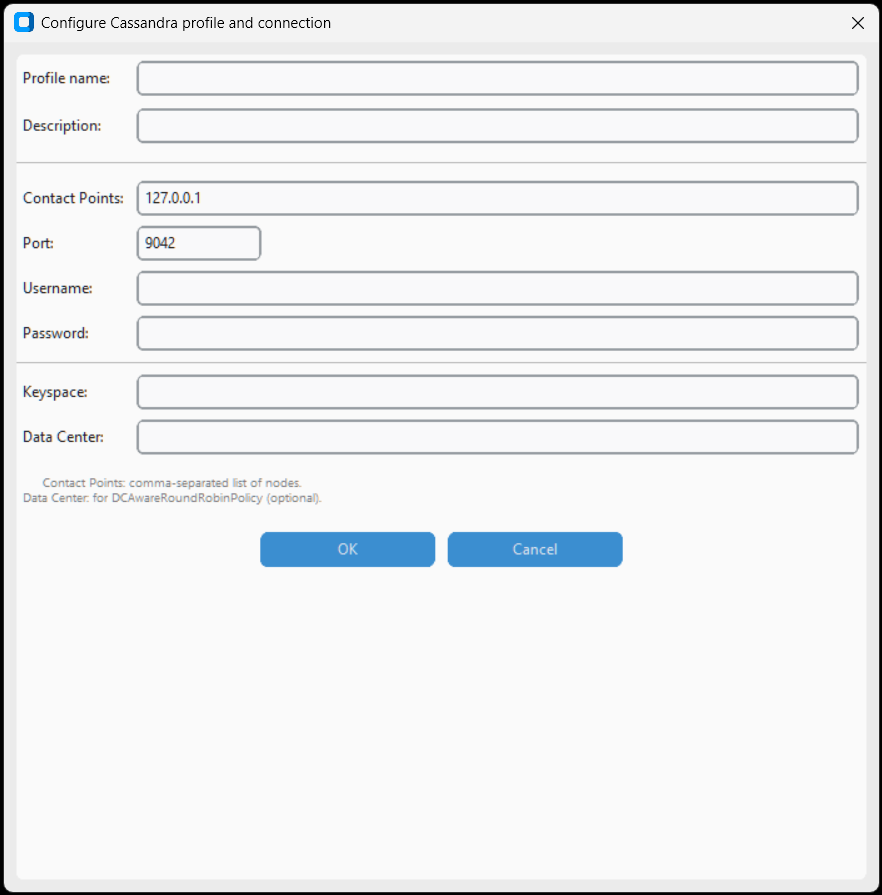
Connessione a cluster Apache Cassandra. Configura nodi di contatto, porta, keyspace e credenziali.
- Contact points — Nodi del cluster (separati da virgola)
- Porta — Porta nativa (default:
9042) - Keyspace — Keyspace target
- Username / Password — Credenziali (se autenticazione abilitata)
Cloud Storage
Amazon S3
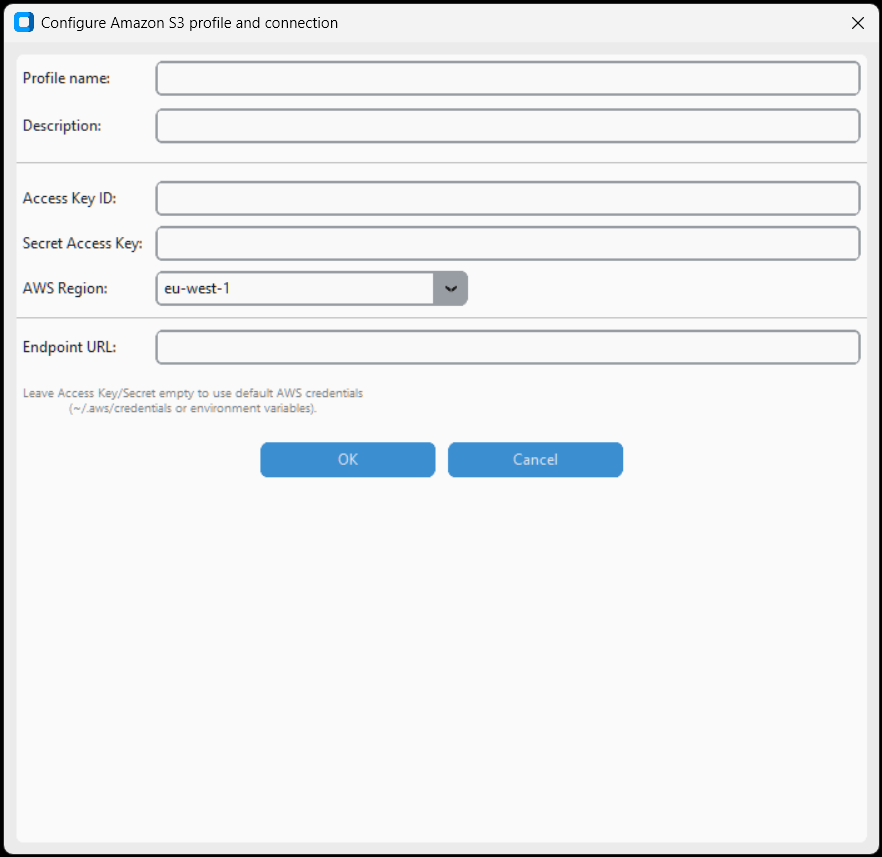
Legge file da bucket Amazon S3. Configura Access Key, Secret Key, regione e percorso bucket/file.
- Access Key ID / Secret Access Key — Credenziali IAM AWS
- Region — Regione AWS (es.
eu-west-1) - Bucket name — Nome del bucket
- File path/prefix — Percorso al file nel bucket
Azure Blob Storage
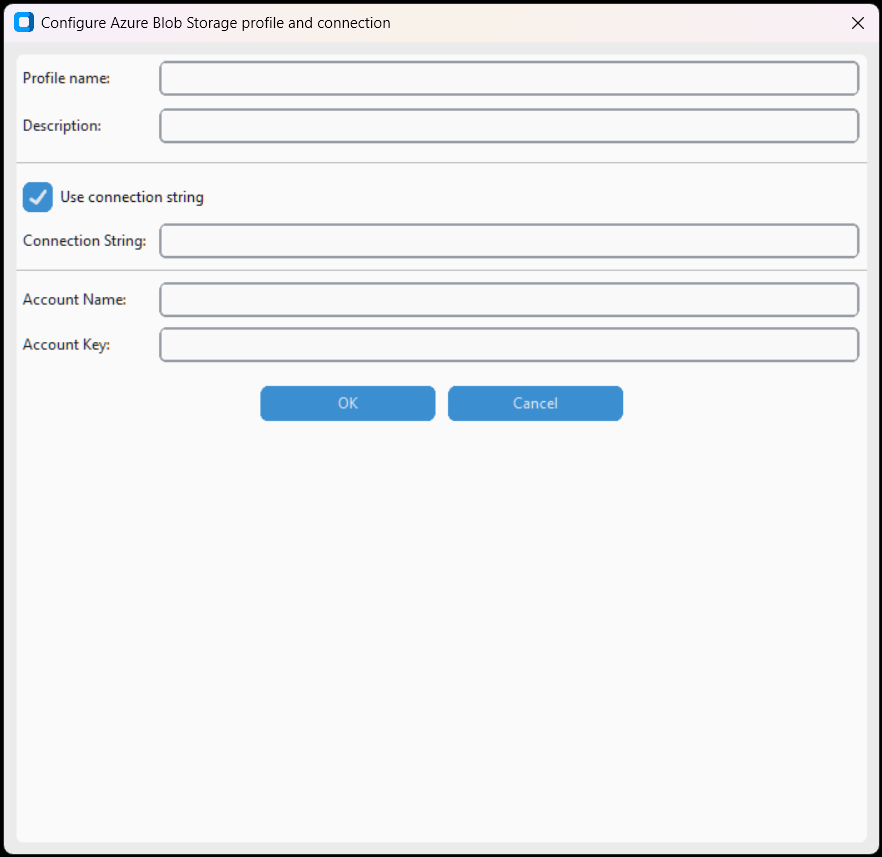
Legge file da Azure Blob Storage. Configura connection string o account name + key, container e percorso blob.
- Connection string — Stringa di connessione completa (alternativa ad account + key)
- Account name / Account key — Credenziali storage account
- Container — Nome del container
- Blob path — Percorso al blob
SharePoint / OneDrive
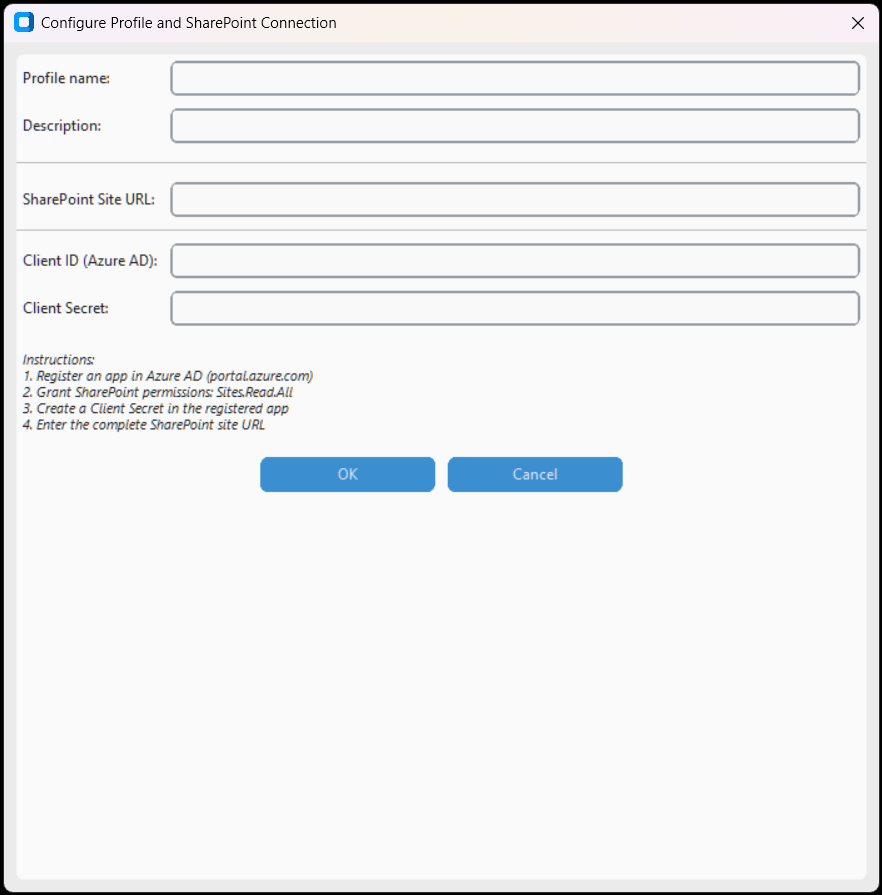
Accede a file su SharePoint Online e OneDrive for Business. Autenticazione tramite Azure AD (Client ID, Secret, Tenant ID).
- Tenant ID — ID tenant Azure AD
- Client ID / Client Secret — Credenziali app Azure registrata
- Site URL — URL del sito SharePoint
- File path — Percorso al file nella libreria documenti
NoSQL e Enterprise
MongoDB
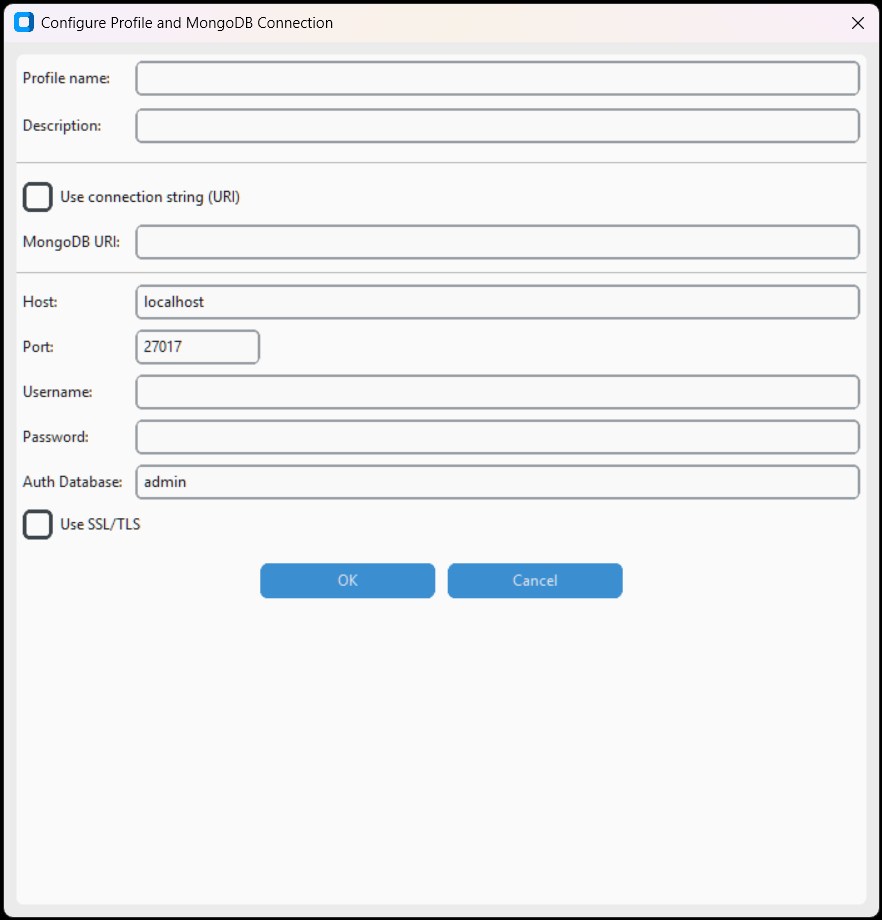
Connessione a MongoDB. Supporta connessione via URI o campi separati (host, porta, database, credenziali). Opzione SSL/TLS.
- Usa stringa di connessione (URI) — Connessione via URI MongoDB completa
- Host / Port — Server e porta (default:
27017) - Username / Password — Credenziali
- Auth Database — Database di autenticazione (default:
admin) - Usa SSL/TLS — Connessione cifrata
Elasticsearch
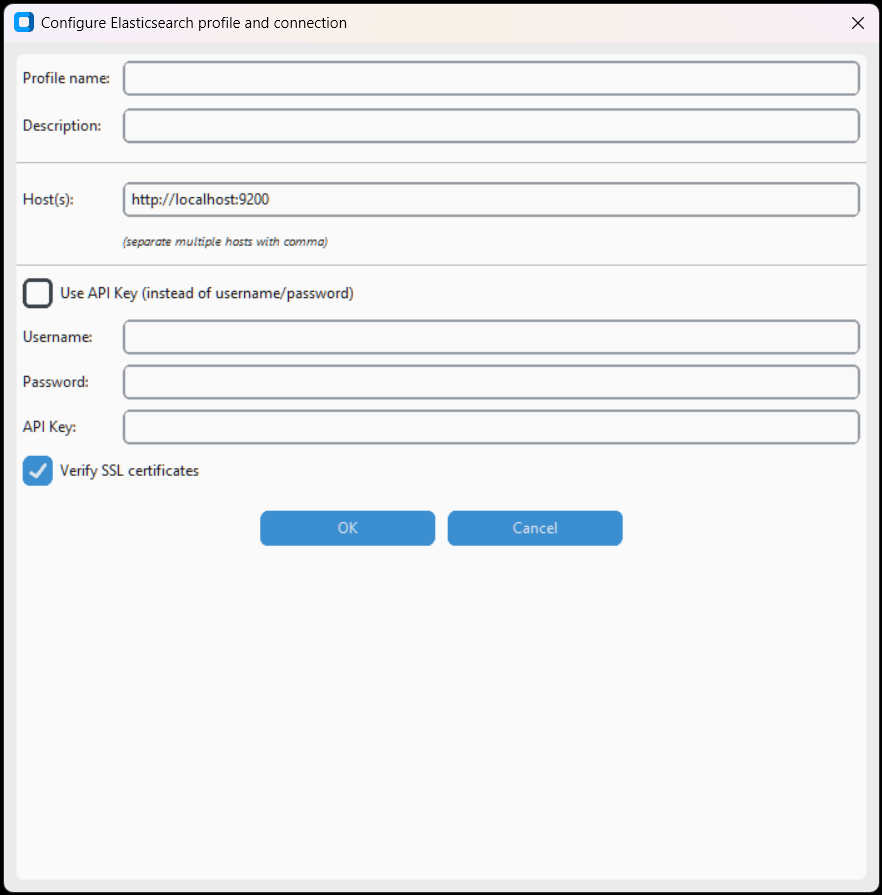
Connessione a cluster Elasticsearch. Configura URL, credenziali e opzione verifica SSL.
- Elasticsearch URL — URL del cluster (es.
https://localhost:9200) - Username / Password — Credenziali (se autenticazione abilitata)
- Verify SSL — Verifica certificato SSL
- API Key — Alternativa alle credenziali
Redis
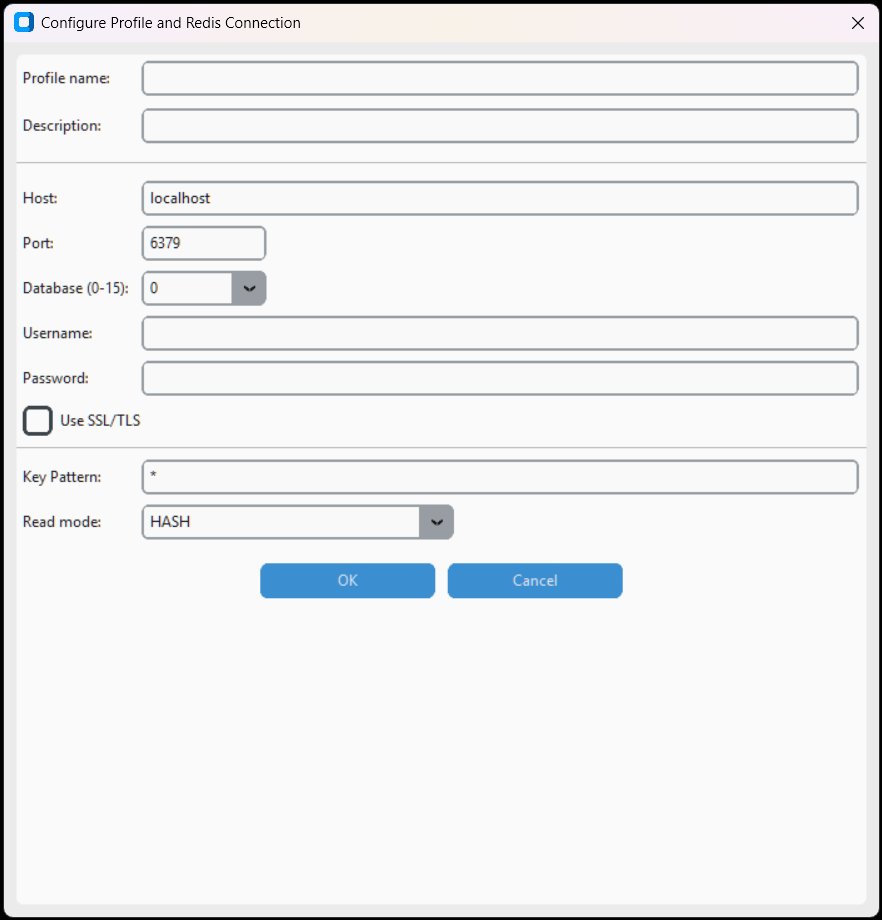
Connessione a Redis. Configura host, porta, password, database index e pattern di filtro chiavi.
- Host / Port — Server e porta (default:
6379) - Password — Password (se configurata)
- Database — Indice database (default:
0) - Key pattern — Pattern glob per filtrare le chiavi (es.
product:*) - Usa SSL/TLS — Connessione cifrata
Neo4j Graph DB
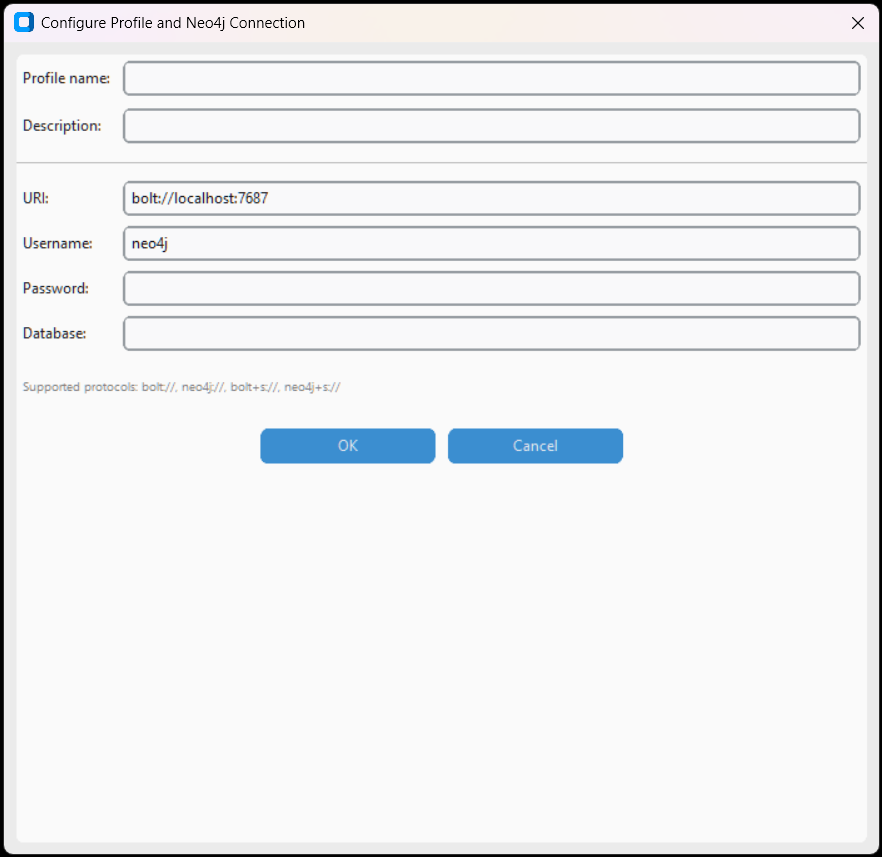
Connessione a Neo4j. Esegue query Cypher per estrarre dati dal database a grafo.
- URI — URI di connessione (es.
bolt://localhost:7687) - Username / Password — Credenziali
- Database — Nome database (default:
neo4j)
Apache Kafka
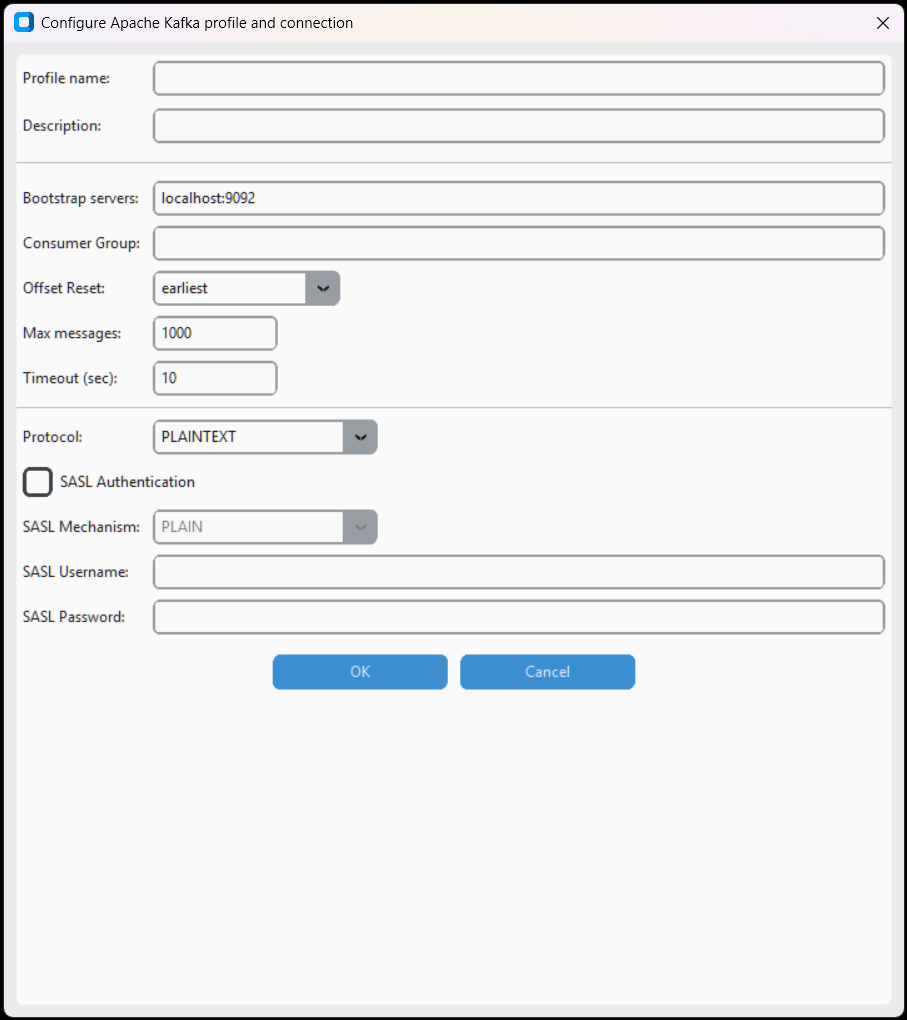
Consuma messaggi da topic Apache Kafka. Configura bootstrap servers, gruppo, topic e formato messaggi (JSON).
- Bootstrap servers — Server Kafka (es.
localhost:9092) - Group ID — Consumer group
- Topic — Nome del topic
- Max messages / Timeout — Limiti di lettura
- Autenticazione SASL — Autenticazione SASL (opzionale)
- SSL/TLS — Connessione cifrata con certificati
Web Services e API
API REST Generica
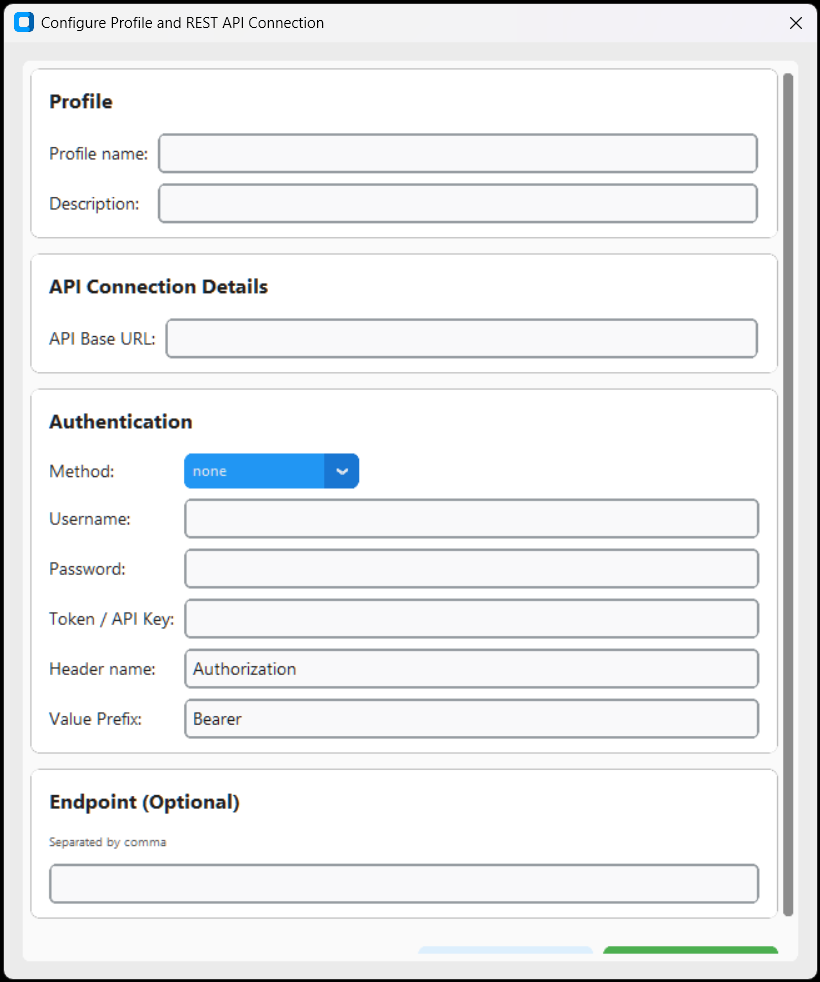
Connessione a qualsiasi API REST. Configura URL base, metodo di autenticazione (None, Basic, Bearer, API Key, OAuth2), header personalizzati e endpoint.
- API Base URL — URL base dell'API
- Method — Metodo di autenticazione: none, basic, bearer, apikey, oauth2
- Username / Password — Per autenticazione Basic
- Token / API Key — Per autenticazione Bearer o API Key
- Header name / Value Prefix — Personalizzazione header (es.
Authorization: Bearer ...) - Endpoint — Endpoint specifici separati da virgola
Servizio OData
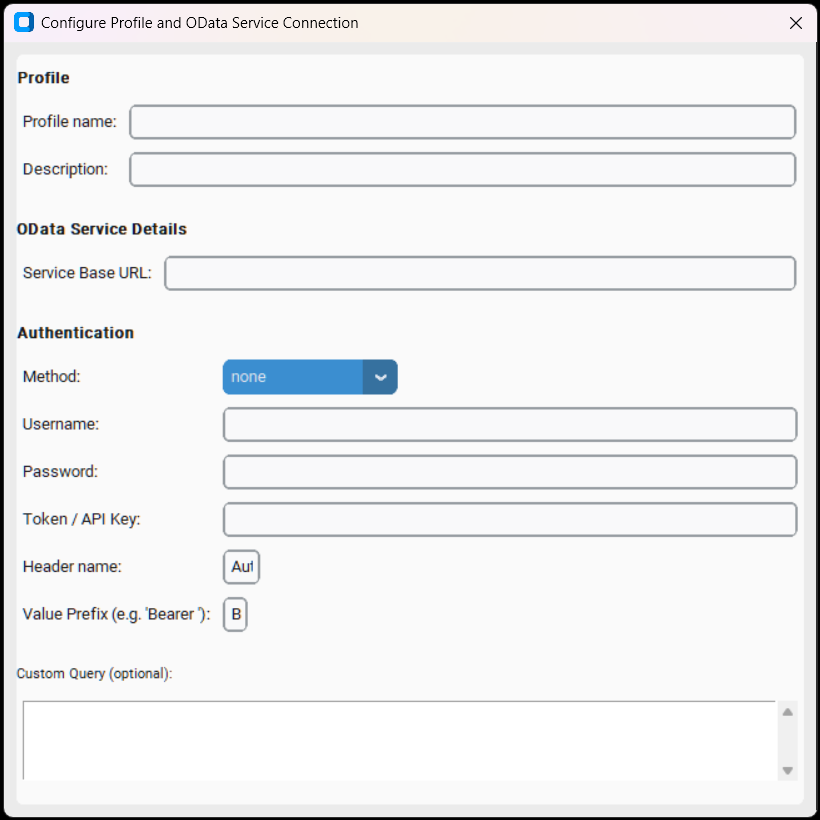
Connessione a servizi OData (Open Data Protocol). Standard web per API RESTful, usato in SAP, Microsoft Dynamics e altri.
- Service Base URL — URL del servizio OData
- Method — Autenticazione: none, basic, bearer, apikey
- Query Personalizzata — Filtro OData personalizzato
Web Service SOAP (WSDL)
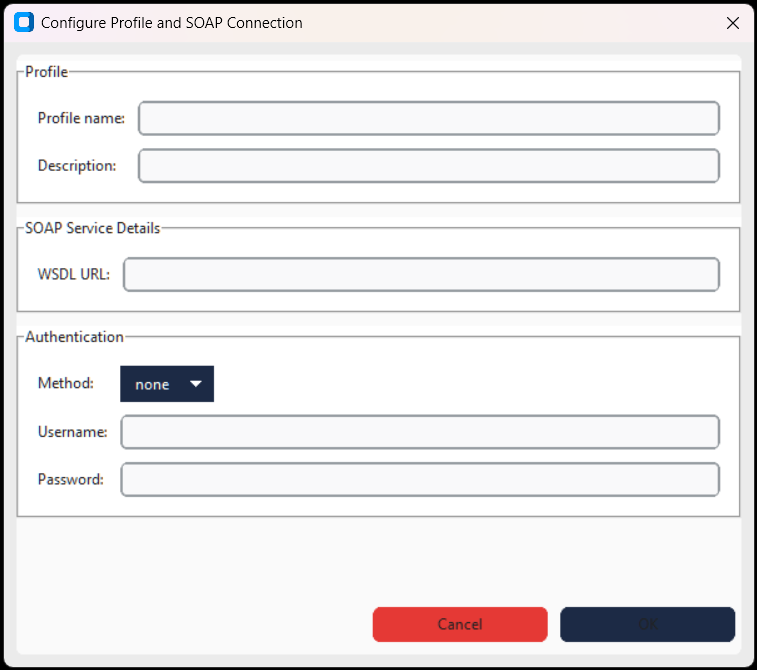
Connessione a web service SOAP tramite descrittore WSDL. Supporta autenticazione WS-Security.
- WSDL URL — URL del file WSDL
- Username / Password — Credenziali WS-Security (opzionali)
Google Sheets
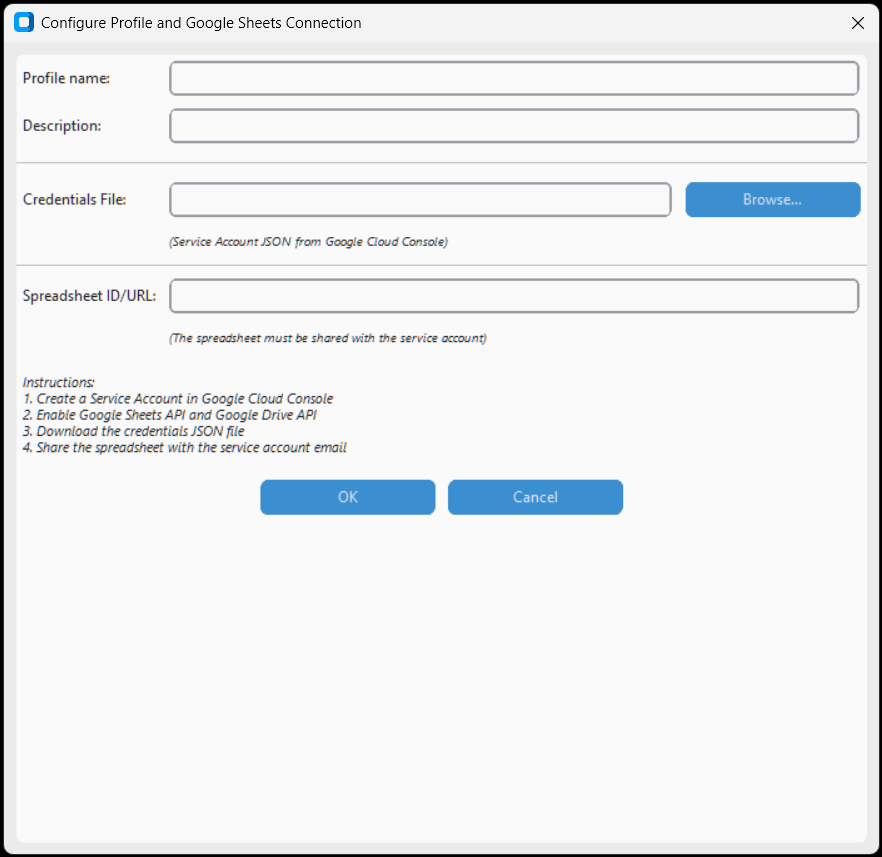
Importa dati da fogli Google Sheets. Autenticazione tramite file JSON credenziali service account Google.
- Credentials JSON file — File JSON delle credenziali service account Google
- Spreadsheet ID — ID del foglio Google (dalla URL)
- Sheet name — Nome del foglio specifico (opzionale)
Cloud Analytics
Google Analytics GA4
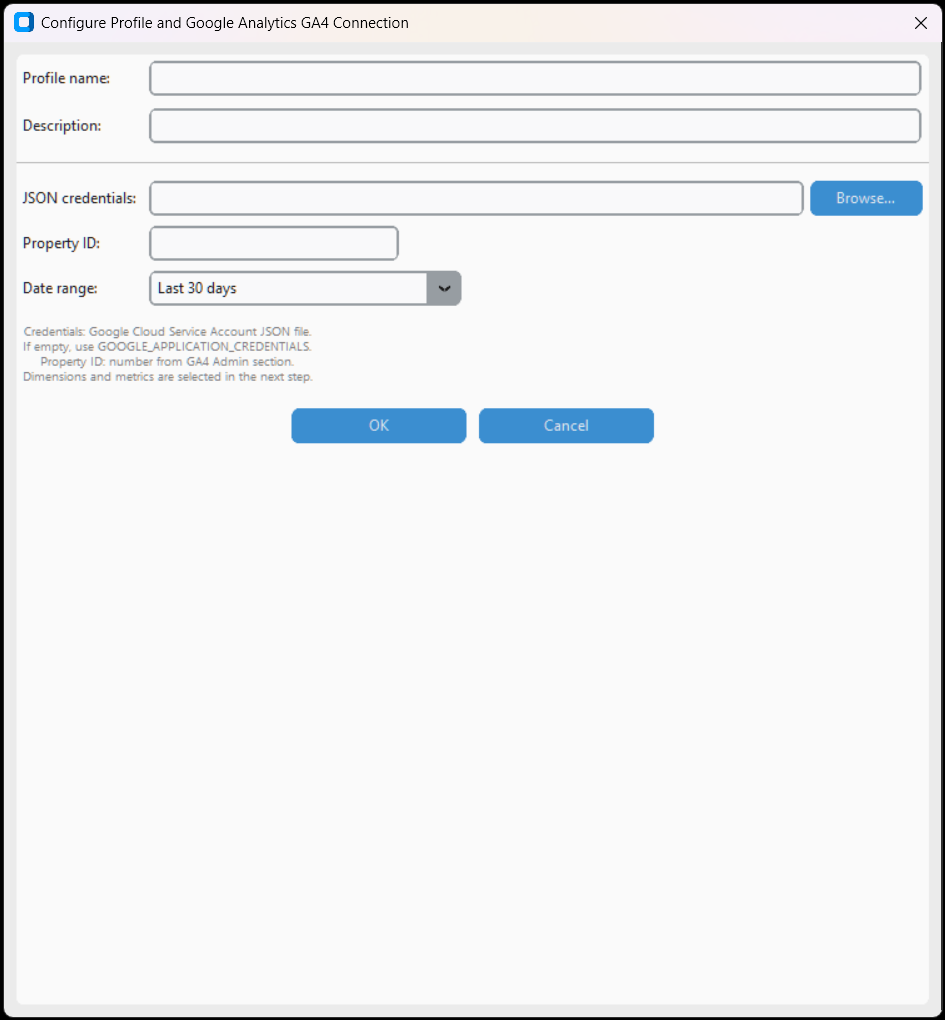
Estrae dati da Google Analytics 4. Configura credenziali service account, Property ID, intervallo date e metriche/dimensioni desiderate.
- Credentials JSON file — Service account Google
- Property ID — ID proprietà GA4
- Start date / End date — Intervallo temporale
- Metrics — Metriche da estrarre (es.
sessions,activeUsers) - Dimensioni — Dimensioni (es.
country,pagePath)
Salesforce CRM
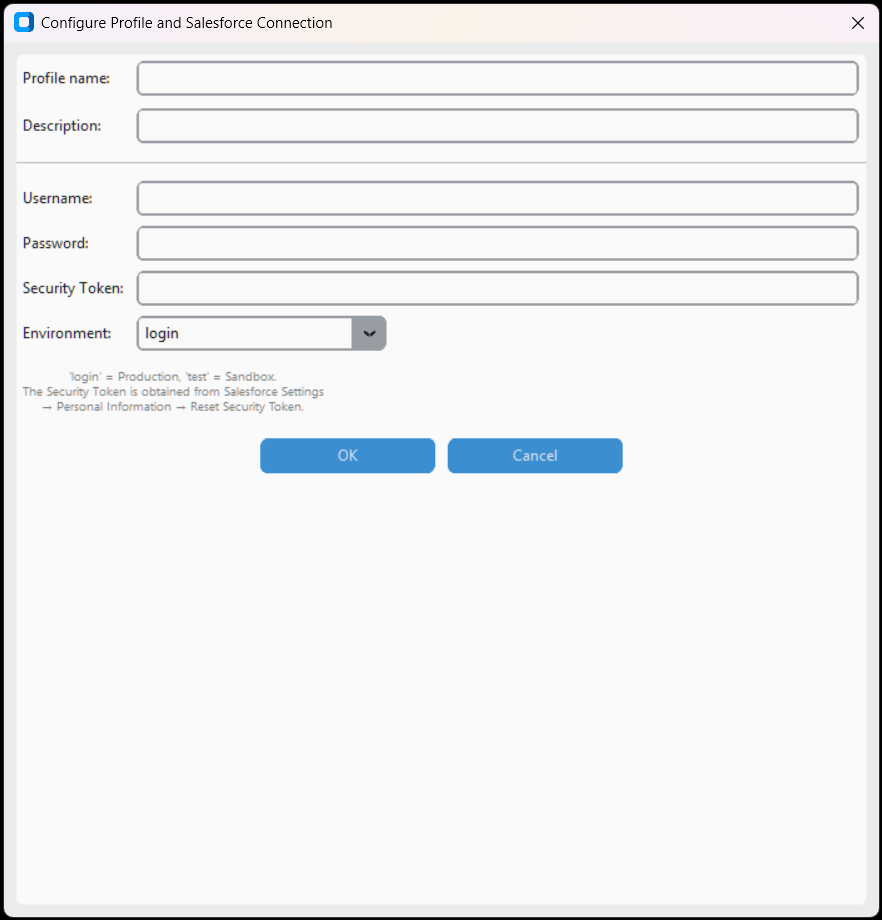
Connessione a Salesforce CRM. Autenticazione tramite username, password e security token. Esegue query SOQL per estrarre dati.
- Username — Email utente Salesforce
- Password — Password
- Security Token — Token di sicurezza Salesforce
- Domain — Dominio (default:
login, per sandbox:test)
Time Series
InfluxDB
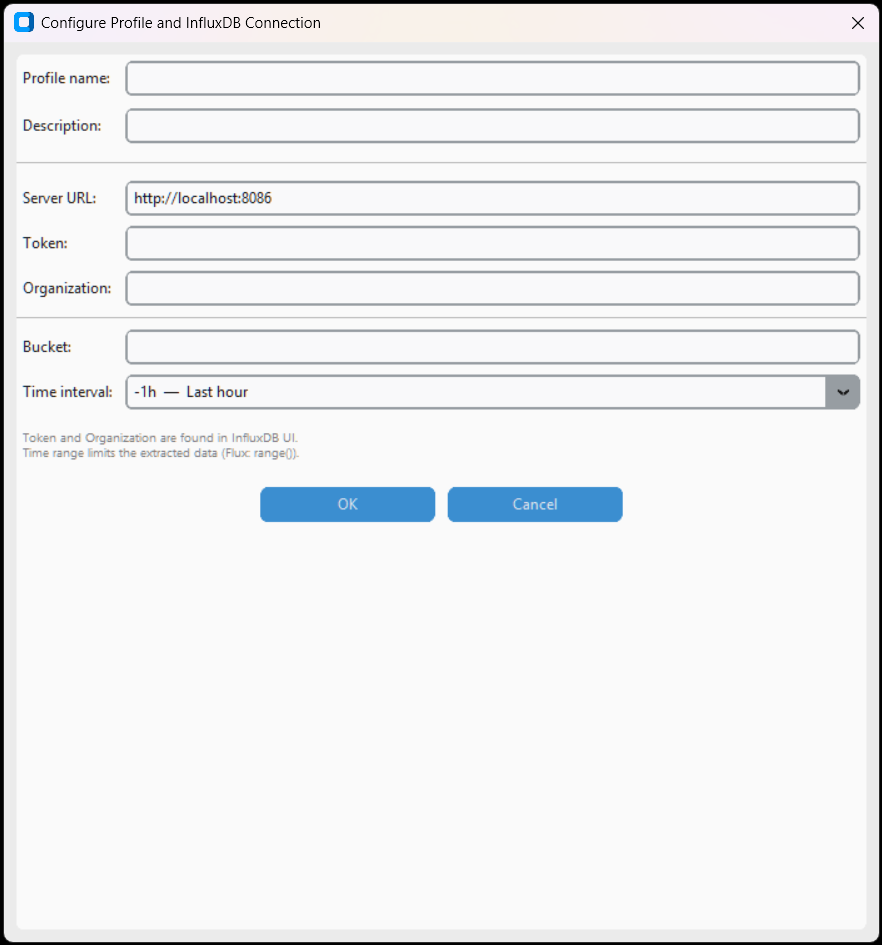
Connessione a InfluxDB per dati di serie temporali. Configura URL, token, organizzazione e bucket.
- URL — URL del server InfluxDB (es.
http://localhost:8086) - Token — Token di autenticazione
- Organization — Nome organizzazione
- Bucket — Nome del bucket dati
- Verify SSL — Verifica certificato
Email e Database locale
Microsoft Outlook
Legge dati dalla casella di posta Outlook locale (contatti, email, calendario). Richiede Outlook installato.
Database Permanente (Locale)
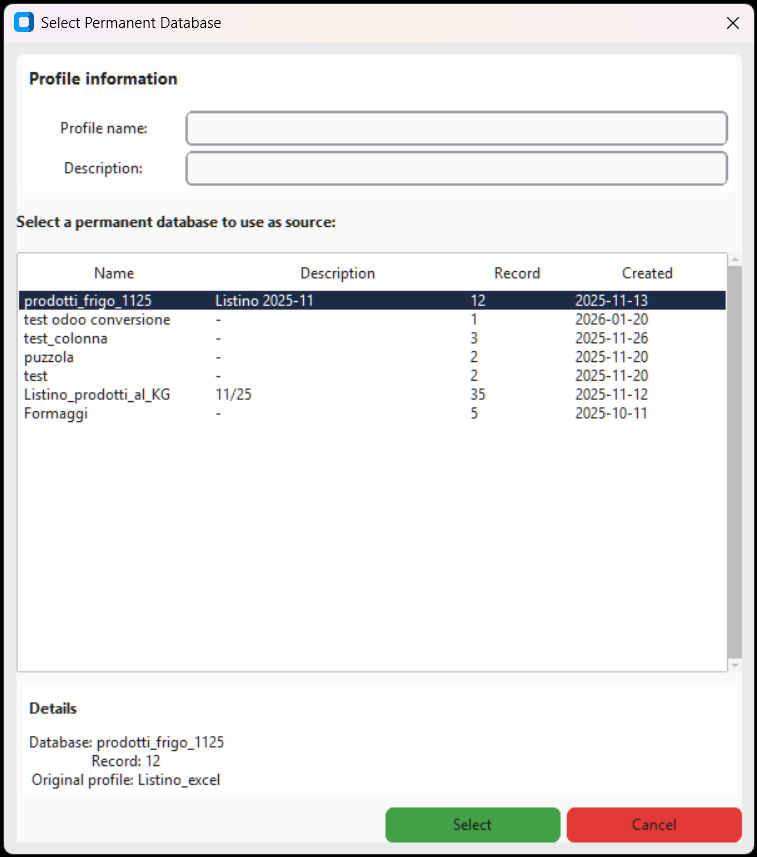
Database SQLite integrato nell'applicazione. Permette di creare e gestire dataset persistenti senza sorgenti esterne.
- Database selection — Seleziona un database esistente o creane uno nuovo
- Import data — Importa dati da file Excel/CSV nel database permanente
Connettori generici
ODBC Generico

Connessione tramite driver ODBC a qualsiasi database compatibile. Supporta DSN (Data Source Name) e connessione diretta via driver. Ideale per sorgenti non coperte da connettori specifici.
- Connection mode — DSN (Data Source Name preconfigurato) o Driver + Parametri (connessione diretta)
- DSN — Nome DSN configurato nel sistema
- Driver ODBC — Driver installato. Altri... lista i driver disponibili
- Server / Database — Parametri di connessione
- Windows Authentication — Usa credenziali Windows
- RECOMMENDED: Use Read Uncommitted — Evita blocchi database
- Query Personalizzata — Query SQL personalizzata
OLE DB Generico

Connessione tramite provider OLE DB. Supporta stringa di connessione diretta e file UDL (Universal Data Link). Solo Windows.
- Connection mode — Stringa Provider (stringa di connessione) o File Data Link (.udl)
- OLE DB Provider — Provider installato (es. Microsoft.ACE.OLEDB.12.0)
- UDL file path — File Universal Data Link preconfigurato
- Credentials — Username/Password opzionali (sovrascrivono la stringa)
- Enable Database Performance Optimization — Read Uncommitted
- Query Personalizzata — Query SQL personalizzata
JDBC Generico
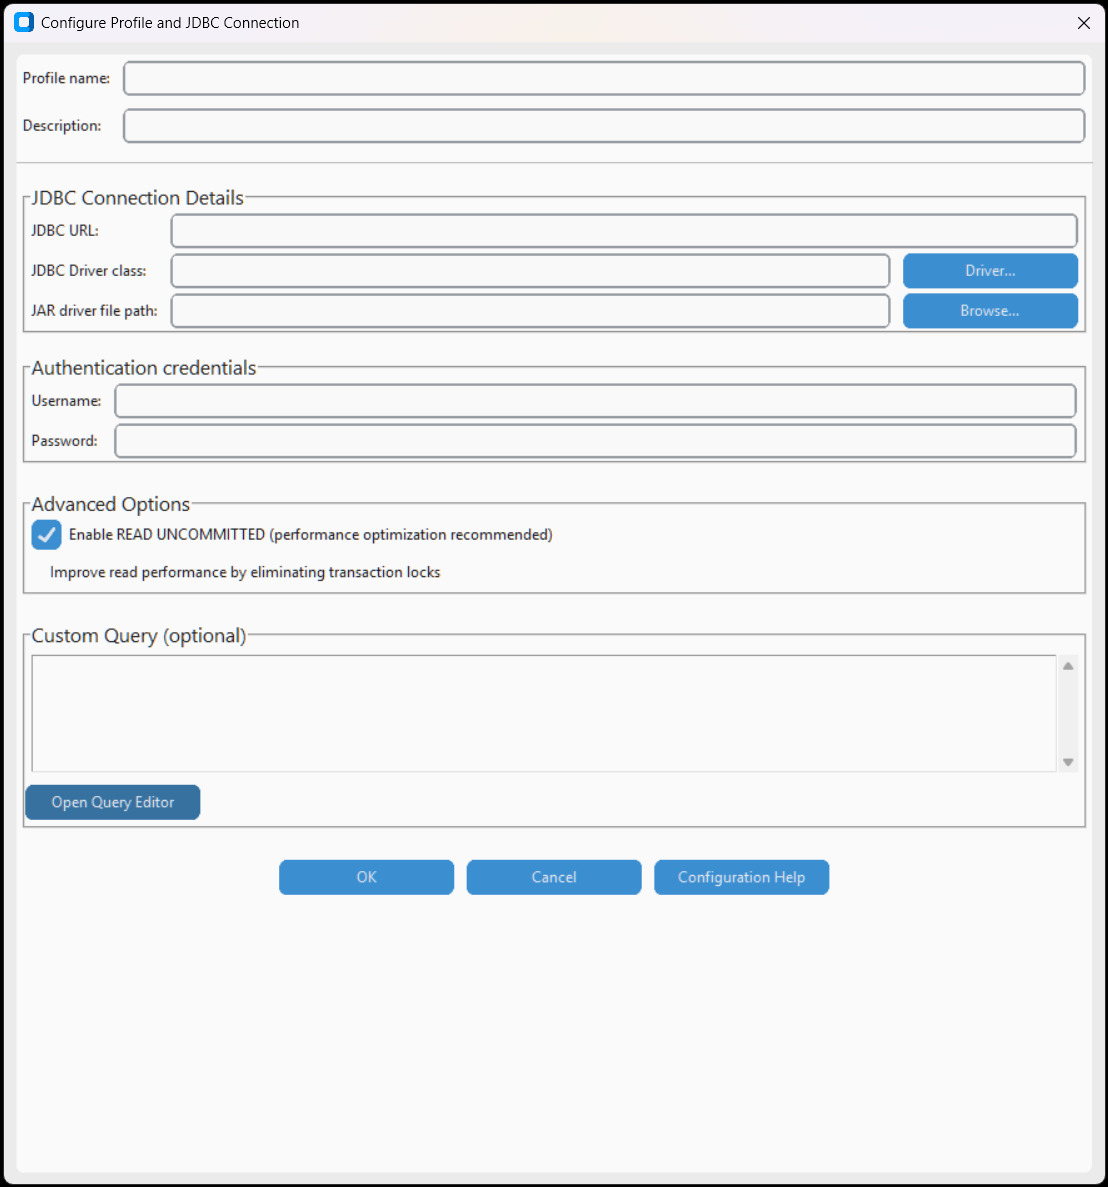
Connessione tramite driver JDBC (Java). Richiede JRE installato e file JAR del driver. Supporta qualsiasi database con driver JDBC disponibile.
- JRE path — Percorso all'installazione Java
- JAR file — File .jar del driver JDBC
- JDBC URL — URL di connessione JDBC (es.
jdbc:mysql://host:3306/db) - Driver class — Classe Java del driver
- Username / Password — Credenziali
- Query Personalizzata — Query SQL personalizzata